
检测与评测
HELM
斯坦福 CRFM 主导的大语言模型全方位基准评测框架
访问官网
crfm.stanford.edu
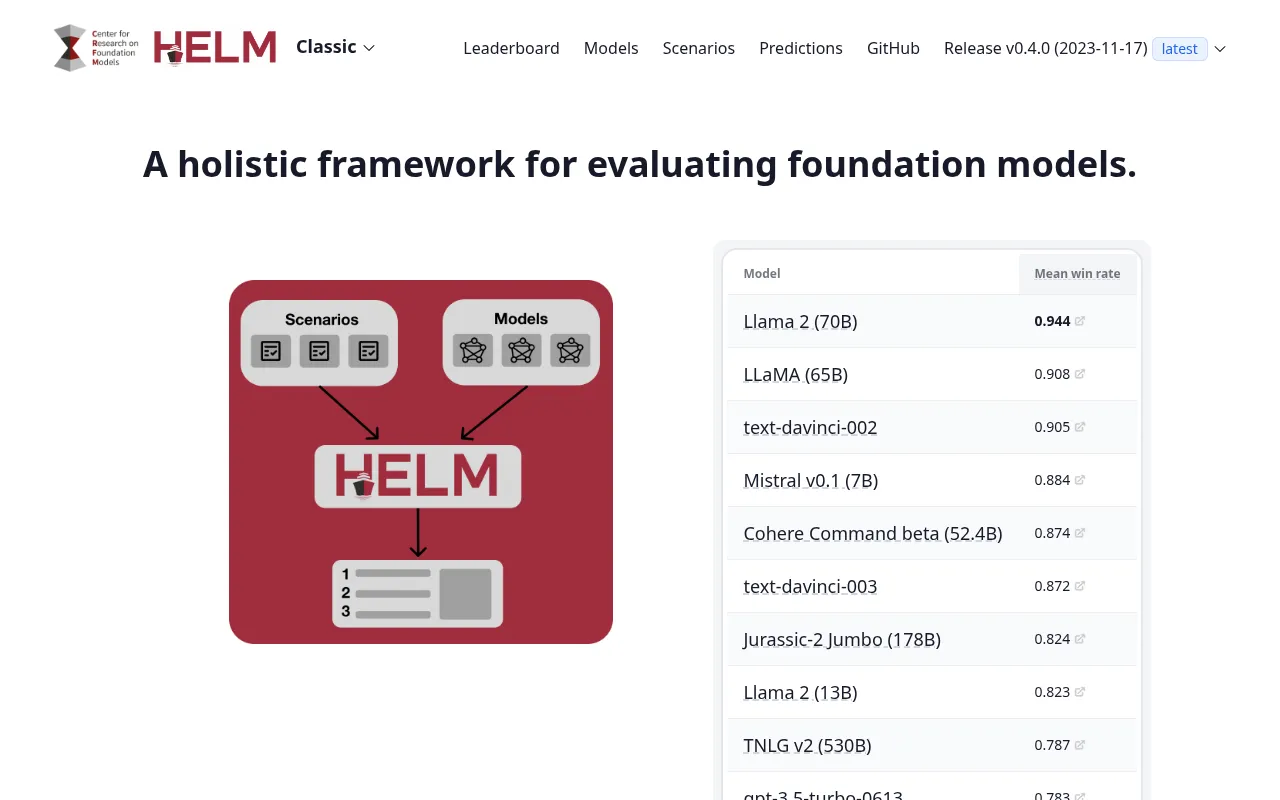
HELM是什么
HELM(Holistic Evaluation of Language Models)是由斯坦福大学以人为本人工智能研究中心(CRFM)发起的一项综合性评估倡议。该项目旨在通过标准化的基准测试,全面衡量当前大语言模型在多种任务、场景及指标下的表现,为研究者和开发者提供透明、可复现的模型能力参考。
作为开源项目,HELM 整合了多样化的数据集和评估指标,覆盖了从传统自然语言处理任务到新兴生成式能力的广泛领域。它不仅仅关注准确率,还深入考察模型的鲁棒性、公平性以及效率,帮助社区更客观地理解不同模型架构的优势与局限。
主要功能
- 全方位评估不仅测试准确性,还涵盖校准、鲁棒性、公平性和毒性等多个维度的模型表现。
- 标准化基准提供统一的评估流程和接口,确保不同模型之间的比较具有科学性和可比性。
- 广泛的任务覆盖支持包括问答、摘要、代码生成、常识推理在内的多种主流 NLP 任务场景。
- 开源透明代码和数据集公开可用,促进社区协作和对评估结果的独立验证。
- 多模型支持能够接入并评估市面上主流的开源及闭源大语言模型,持续更新模型列表。
如何使用
- 访问 HELM 官方网站查看最新的排行榜和详细评估报告。
- 查阅官方文档了解支持的模型列表和具体的评估任务定义。
- 如需复现实验,可从 GitHub 仓库克隆 HELM 开源代码库。
- 配置本地环境并安装必要的依赖包以运行评估脚本。
- 选择目标模型和数据集,执行评估命令并生成结果报告。
应用场景
- 学术研究研究人员利用 HELM 基准对比新提出的模型架构与现有 SOTA 模型的差距。
- 模型选型企业开发者根据特定任务(如代码或摘要)的评测得分,选择最适合业务的基座模型。
- 安全性审计通过公平性和毒性指标,评估模型在部署前是否存在潜在的偏见或安全风险。
价格 / 免费额度
HELM 是开源研究项目,具体使用成本取决于计算资源消耗,详情请以官网为准。
适合人群
- AI 研究人员
- 大模型开发者
- 数据科学家
- 技术决策者
常见问题
HELM 主要评估哪些类型的模型?
HELM 主要评估大语言模型(LLMs),涵盖开源和闭源的主流模型,具体列表随项目更新而变化。
我可以自己运行 HELM 评估吗?
可以,HELM 是开源的,您可以从 GitHub 获取代码并在本地环境中运行评估流程。
HELM 的评估指标包括什么?
除了传统的准确率和 perplexity,还包括校准度、鲁棒性、公平性、效率和毒性等全方位指标。