
模型与资源
LLaMA
Meta 开源大语言模型系列,提供从 7B 到 70B 参数的预训练与微调权重及推理代码
访问官网
github.com
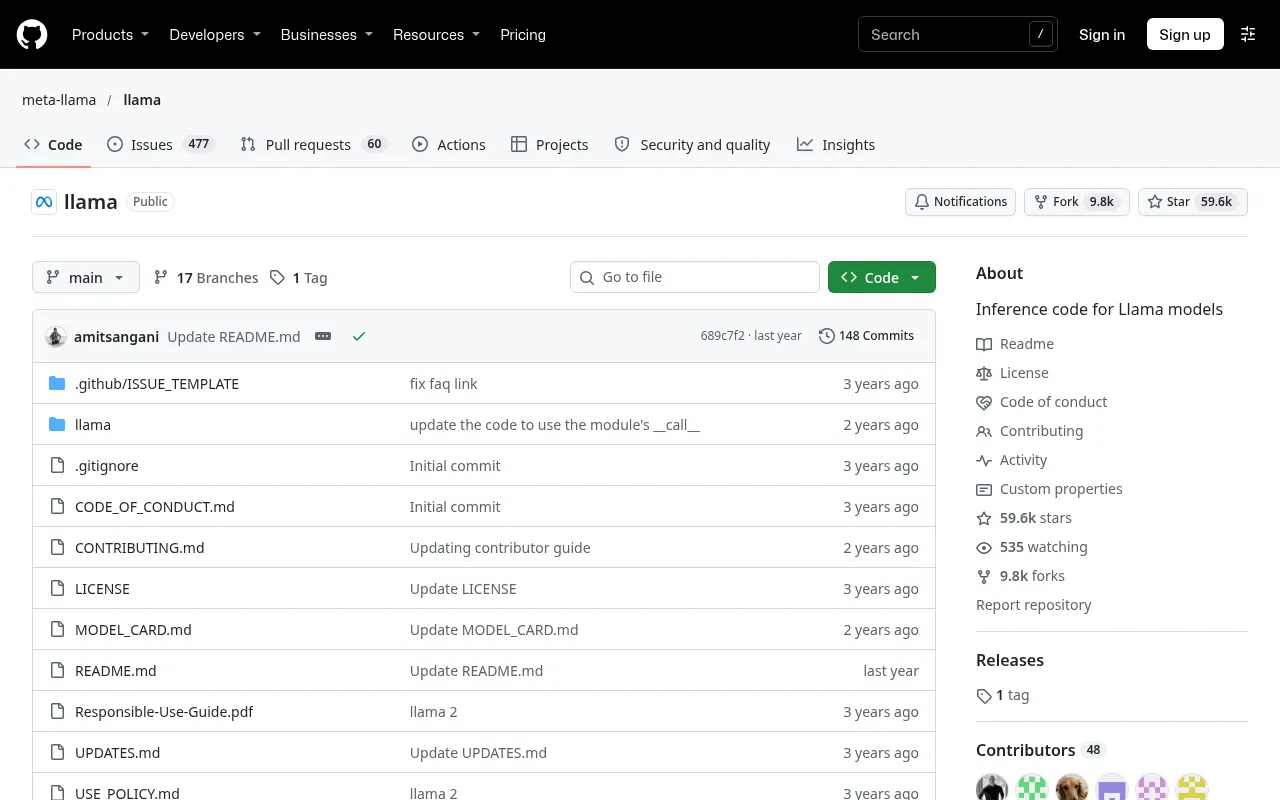
LLaMA是什么
LLaMA 是由 Meta 发布的大型语言模型系列,旨在为研究人员、开发者和企业提供可访问的基础模型资源。该系列涵盖了从 70 亿到 700 亿参数的多种规模模型,支持预训练和经过指令微调的版本,帮助用户在本地环境中进行实验、创新并负责任地扩展应用。
官方仓库提供了加载 LLaMA 模型并运行推理的最小化示例代码,包括文本补全和对话完成功能。随着 Llama 3.1 的发布,Meta 已将相关资源整合至 Llama Stack 生态系统中,包括专注于基础模型的 llama-models、安全性组件 PurpleLlama 以及端到端代理系统 llama-agentic-system。
用户可以通过 Meta 官方网站申请下载模型权重和分词器,或通过 Hugging Face 获取访问权限。该工具包支持在配备 PyTorch 和 CUDA 的环境中快速部署,允许开发者根据硬件条件调整并行处理参数和序列长度,实现高效的本地推理体验。
主要功能
- 多规模模型支持提供从 7B、13B 到 70B 不同参数量级的预训练和微调模型,满足多样化的计算资源需求。
- 本地推理代码包含最小化的 Python 脚本示例,支持文本补全和对话完成模式的本地运行。
- Llama Stack 集成作为 Llama 生态系统的一部分,可与 llama-toolchain 和 llama-agentic-system 等组件协同工作。
- 灵活的分片策略支持模型并行(Model Parallelism),根据模型大小自动推荐所需的 GPU 进程数(如 70B 需 8 个进程)。
- 长上下文支持所有模型均支持高达 4096 个 token 的序列长度,可根据硬件内存预分配缓存。
- 安全与责任使用提供详细的使用政策、责任指南以及 PurpleLlama 安全缓解组件,确保合规使用。
如何使用
- 访问 Meta 官方网站或 Hugging Face 页面,接受许可协议并申请下载模型权重和分词器的权限。
- 在收到包含签名 URL 的电子邮件后,克隆官方 GitHub 仓库并在顶级目录运行 pip install -e .安装依赖。
- 赋予 download.sh 脚本执行权限,运行该脚本并在提示时手动输入邮件中提供的下载链接。
- 根据模型大小配置模型并行参数(如 7B 设为 1,70B 设为 8),并调整 max_seq_len 和 max_batch_size。
- 使用 torchrun 命令运行 example_chat_completion.py 或 example_text_completion.py 启动本地推理测试。
应用场景
- 本地研究与实验研究人员可在本地硬件上加载不同规模的模型,进行算法验证和性能基准测试。
- 私有化部署应用企业可将模型权重下载至内部服务器,构建不依赖外部 API 的安全对话机器人或文本生成工具。
- 模型微调基础开发者可利用预训练权重作为起点,结合 llama-cookbook 中的脚本进行特定领域的指令微调。
价格 / 免费额度
免费开放,但需通过 Meta 官网或 Hugging Face 申请访问权限并接受许可协议。以官网为准。
适合人群
- AI 研究人员
- 机器学习工程师
- 隐私优先的企业开发者
- 开源社区贡献者
常见问题
如何获取 LLaMA 模型的下载链接?
您需要访问 Meta 官方网站或 Hugging Face 模型卡片,接受许可协议并提交申请。审核通过后,您将收到一封包含限时签名下载链接的电子邮件。
LLaMA 2 仓库是否还在维护?
该仓库已标记为弃用。Meta 建议用户转向新的 Llama Stack 相关仓库,如 llama-models 和 llama-toolchain,以获取最新的功能和支持。