
AI开发平台
MLX
专为 Apple Silicon 设计的轻量级机器学习框架,实现统一内存下的高效模型训练与推理。
访问官网
ml-explore.github.io
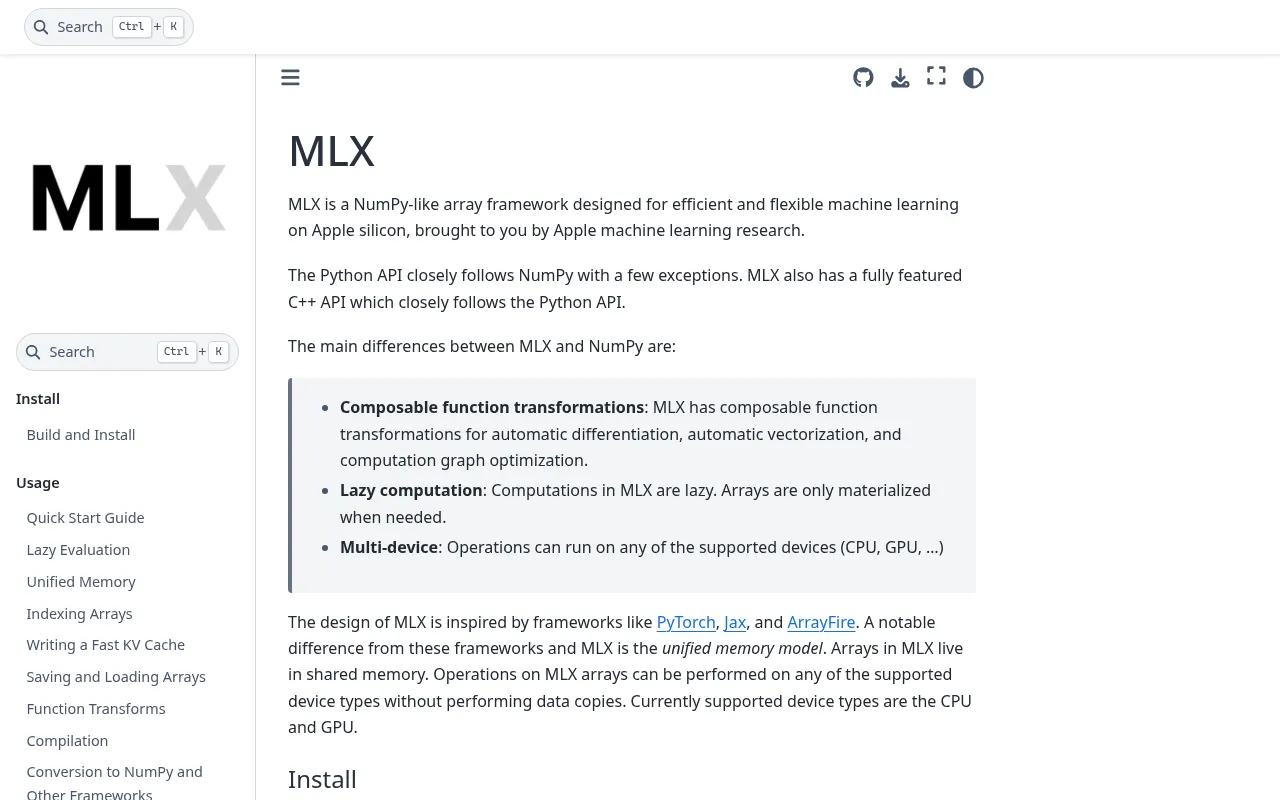
MLX是什么
MLX 是由 Apple 机器智能研究团队开发的数组框架,旨在简化 Apple 芯片(如 M 系列)上的机器学习开发。它采用类似 NumPy 的 API 设计,降低了学习门槛,同时通过延迟执行和计算图优化技术,在保持代码简洁性的同时提供高性能。
该框架的核心优势在于其统一内存架构,数据无需在 CPU 和 GPU 之间复制,即可被所有处理器核心访问。这不仅减少了内存开销,还显著提升了大规模模型训练和推理的速度。MLX 支持动态图构建,允许开发者灵活地改变计算流程,非常适合研究和快速原型开发。
除了基础张量操作,MLX 还提供了自动微分、编译优化以及针对 Transformer 架构的高级原语(如快速注意力机制和 RoPE)。无论是进行线性回归实验,还是部署大型语言模型,MLX 都能为 macOS 用户提供一个高效、原生且易于扩展的开发环境。
主要功能
- 统一内存架构数据存储在共享内存中,CPU、GPU 和神经引擎可直接访问,消除数据复制带来的延迟和开销。
- 类 NumPy API提供熟悉且直观的接口,支持多维数组操作、广播机制和丰富的数学函数,便于现有 Python 用户迁移。
- 延迟执行与编译采用惰性求值策略构建计算图,并通过 mlx.core.compile 进行即时编译优化,提升运行时效率。
- 自动微分内置 grad、value_and_grad 等变换函数,支持高阶导数计算,轻松实现复杂模型的梯度更新。
- Transformer 优化原语包含 fast.scaled_dot_product_attention、fast.rope 和 fast.rms_norm 等专用算子,加速大模型推理。
- 多设备并行支持支持数据并行和张量并行,能够利用多个 Apple 芯片或核心进行分布式训练和大规模计算。
如何使用
- 1.确保你的 Mac 运行 macOS 并安装了 Python 环境。
- 2.使用 pip 安装 MLX:在终端运行 `pip install mlx`。
- 3.导入库并创建数组:使用 `import mlx.core as mx` 和 `mx.array()` 初始化数据。
- 4.执行计算:利用内置的数学函数(如 mx.add, mx.matmul)进行张量运算。
- 5.启用编译优化:对频繁调用的函数使用 `mx.compile` 装饰器以提升性能。
- 6.保存与加载:使用 `mx.save` 和 `mx.load` 管理模型权重和数据状态。
应用场景
- 大语言模型本地推理利用统一内存优势,在 MacBook 上高效运行 Llama 等开源大模型,实现低延迟对话体验。
- 学术研究原型开发借助动态图和自动微分功能,快速验证新的神经网络架构和损失函数设计。
- 高性能数值计算替代传统 NumPy 工作流,在 Apple 硬件上获得更快的矩阵运算和数据处理速度。
价格 / 免费额度
MLX 是开源框架,免费使用。具体部署成本取决于硬件资源,以官网为准。
适合人群
- Apple 生态开发者
- 机器学习研究人员
- 大模型应用工程师
- 数据科学家
常见问题
MLX 可以在 Windows 或 Linux 上运行吗?
根据官方文档,MLX 专为 Apple Silicon 设计,主要支持 macOS 环境。其他平台的支持情况请以官方最新公告为准。
MLX 与 PyTorch 或 TensorFlow 有什么区别?
MLX 更轻量级,专注于 Apple 硬件的统一内存架构,API 风格接近 NumPy,适合在 Mac 上进行高效的原型开发和推理,而非跨平台的大规模工业部署。
如何加速我的 MLX 代码?
可以使用 `mlx.core.compile` 对函数进行编译优化,并利用 `mlx.fast` 模块中的专用算子(如注意力机制)来替换通用实现。