
检测与评测
PubMedQA
基于 PubMed 摘要的二元医学问答基准数据集与评测排行榜
访问官网
pubmedqa.github.io
PubMedQA是什么
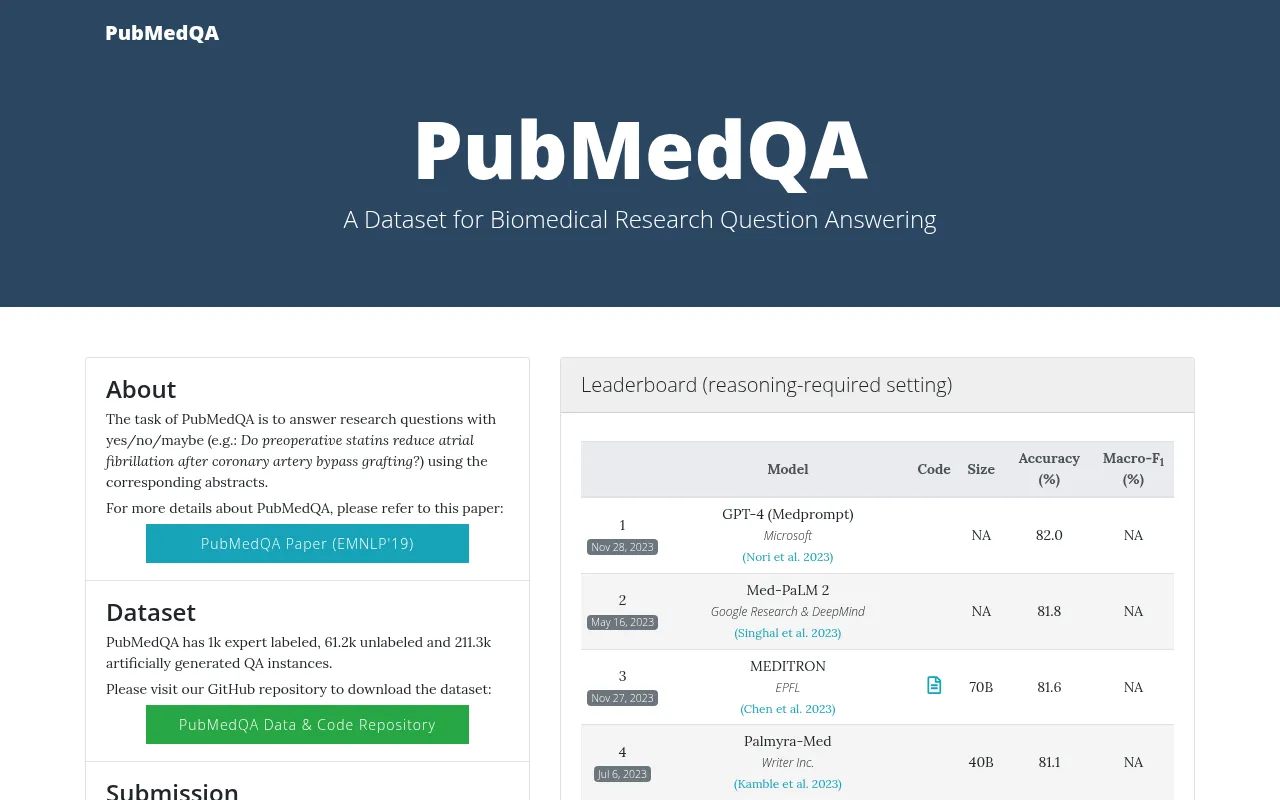
PubMedQA 是一个专为生物医学研究问答设计的基准数据集,其核心任务是利用对应的论文摘要来回答研究问题,答案形式限定为“是”、“否”或“可能”。该数据集旨在评估模型在缺乏全文上下文的情况下,仅凭摘要进行逻辑推理和事实核验的能力。
该项目由 Qiao Jin 等研究者提出,并发表于 EMNLP 2019。数据集包含 1,000 个由专家标注的高质量实例、61,200 个未标注实例以及 211,300 个人工生成的问答对,为自然语言处理在医疗领域的应用提供了丰富的训练和测试资源。
官方网站维护着一个动态更新的排行榜(Leaderboard),展示了包括 GPT-4 (Medprompt)、Med-PaLM 2、MEDITRON 以及人类专家在内的多种模型在该任务上的准确率表现,是衡量生物医学 AI 模型推理能力的重要参考标准。
主要功能
- 专家标注数据包含 1,000 个由领域专家精心标注的问答实例,确保评估基准的高质量和可靠性。
- 大规模语料库提供 61,200 个未标注实例和 211,300 个人工生成的问答对,支持大规模预训练和半监督学习。
- 三元分类任务专注于将研究问题归类为“是”、“否”或“可能”,模拟真实的科研假设验证过程。
- 权威排行榜实时展示各类前沿模型(如 GPT-4、Med-PaLM 2)及人类专家在推理必需设置下的准确率对比。
- 开源可复现数据和代码托管于 GitHub 仓库,方便研究人员下载数据集并提交自己的模型结果。
如何使用
- 访问 PubMedQA 官方网站了解数据集背景和任务定义。
- 前往 GitHub 仓库下载 PubMedQA 数据集及相关代码。
- 使用提供的专家标注数据进行模型训练或微调。
- 在测试集上运行模型,生成 yes/no/maybe 预测结果。
- 按照 GitHub 仓库中的说明提交模型结果以参与排行榜排名。
- 引用 EMNLP 2019 的相关论文以符合学术规范。
应用场景
- 医学 AI 模型评测用于评估大型语言模型在生物医学领域的逻辑推理和事实判断能力。
- 科研辅助工具开发帮助开发者构建能够自动筛选和验证医学文献结论的智能系统。
- 自然语言处理研究作为问答系统(QA)和自然语言推理(NLI)任务的标准测试基准。
价格 / 免费额度
价格与免费额度以官网为准。
适合人群
- 生物医学 NLP 研究人员
- AI 模型开发者
- 医疗数据分析科学家
- 计算语言学学生
常见问题
PubMedQA 的主要任务是什么?
主要任务是根据 PubMed 摘要回答研究问题,答案选项为“是”、“否”或“可能”。
如何获取数据集?
您可以访问官方 GitHub 仓库下载 PubMedQA 的数据和代码。
谁维护着排行榜?
排行榜由 Qiao Jin 维护,并定期更新最新模型的测试结果。
人类专家的表现如何?
根据数据集发布时的数据,人类专家在该任务上的准确率为 78.0%。