
检测与评测
SuperCLUE
中文通用大模型综合性测评基准,深度评估语言理解、创作与安全能力
访问官网
www.cluebenchmarks.com
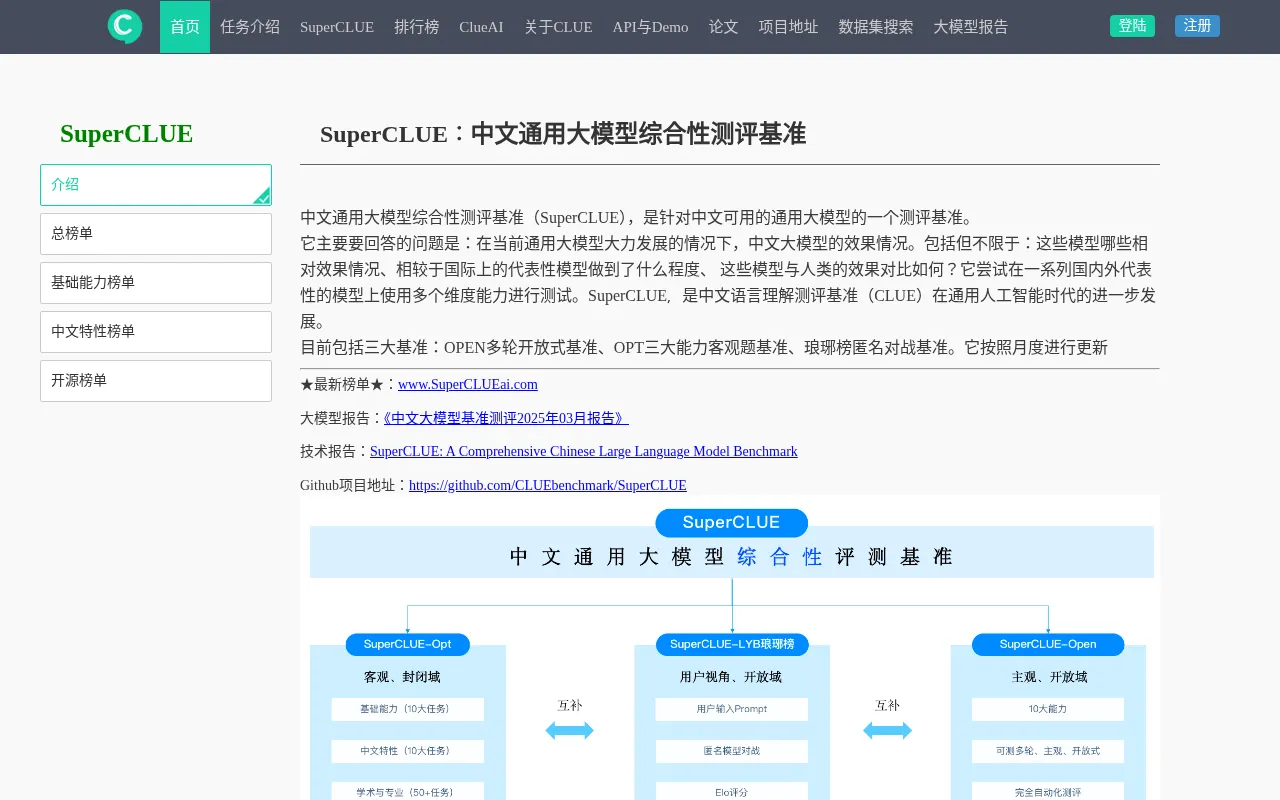
SuperCLUE是什么
SuperCLUE 是面向中文可用通用大模型的综合性测评基准,旨在回答当前中文大模型的效果水平、与国际代表性模型的差距以及与人类能力的对比。作为中文语言理解测评基准(CLUE)在通用人工智能时代的演进,它通过多维度测试提供客观的能力画像。
该基准涵盖 OPEN 多轮开放式基准、OPT 三大能力客观题基准以及琅琊榜匿名对战基准,并按月度更新榜单。SuperCLUE 将能力细化为语言理解与生成、知识理解与应用、专业能力和环境适应与安全性四大象限,共十项基础能力,全面覆盖从闲聊对话到代码生成的各类场景。
主要功能
- 十大基础能力涵盖语言理解、闲聊、上下文对话、生成创作、知识百科、代码、逻辑推理、计算、角色扮演及安全等十个维度的详细评测。
- 中文特性专项针对字形拼音、字义理解、句法分析、文学诗词、成语歇后语、方言对联及古文等中文特有难点进行深度评估。
- 多维榜单体系提供总排行榜、基础能力榜、中文特性榜及开源模型榜,清晰展示不同模型在各项细分能力上的得分表现。
- 月度动态更新榜单按月度进行更新,及时反映最新发布的模型版本及其能力变化,保持评测的时效性。
- 人机对比基准引入人类得分作为参考基准,直观展示顶尖模型与人类在各项能力上的差距与接近程度。
- 安全对抗评估包含专门的安全能力评测,识别模型在面对敏感或不适当请求时的防御机制与合规性表现。
如何使用
- 访问 SuperCLUE 官方网站或 GitHub 项目地址了解最新的评测框架与技术报告。
- 浏览最新榜单页面,查看总排行榜、基础能力榜或中文特性榜中的模型得分详情。
- 根据需求选择特定维度,如代码能力或安全对抗,对比不同模型在该细分领域的表现。
- 参考官方发布的月度大模型基准测评报告,获取更深入的数据分析与行业洞察。
- 如需参与评测或提交新模型结果,可通过官网提供的联系方式或项目地址获取接入指南。
应用场景
- 模型选型参考企业在选择中文大模型时,可依据 SuperCLUE 的基础能力与中文特性得分,挑选最适合自身业务场景的模型。
- 学术研究对比研究人员利用标准化的评测基准,客观比较不同架构或训练策略下的模型在中文语境下的表现差异。
- 安全合规审查开发团队通过安全能力榜单,评估模型在生成内容时的安全性,确保应用符合隐私保护与内容合规要求。
价格 / 免费额度
价格与免费额度以官网为准。
适合人群
- AI 模型开发者
- 自然语言处理研究人员
- 企业技术选型决策者
- 大模型应用工程师
常见问题
SuperCLUE 主要评测哪些能力?
主要评测语言理解与生成、知识理解与应用、专业能力(如代码、逻辑、计算)以及环境适应与安全性等十大基础能力。
榜单多久更新一次?
SuperCLUE 榜单按月度进行更新,以反映最新模型的表现。
如何查看详细的评测数据?
您可以访问 SuperCLUE 官网的最新榜单页面,或查阅官方发布的大模型基准测评报告获取详细数据。